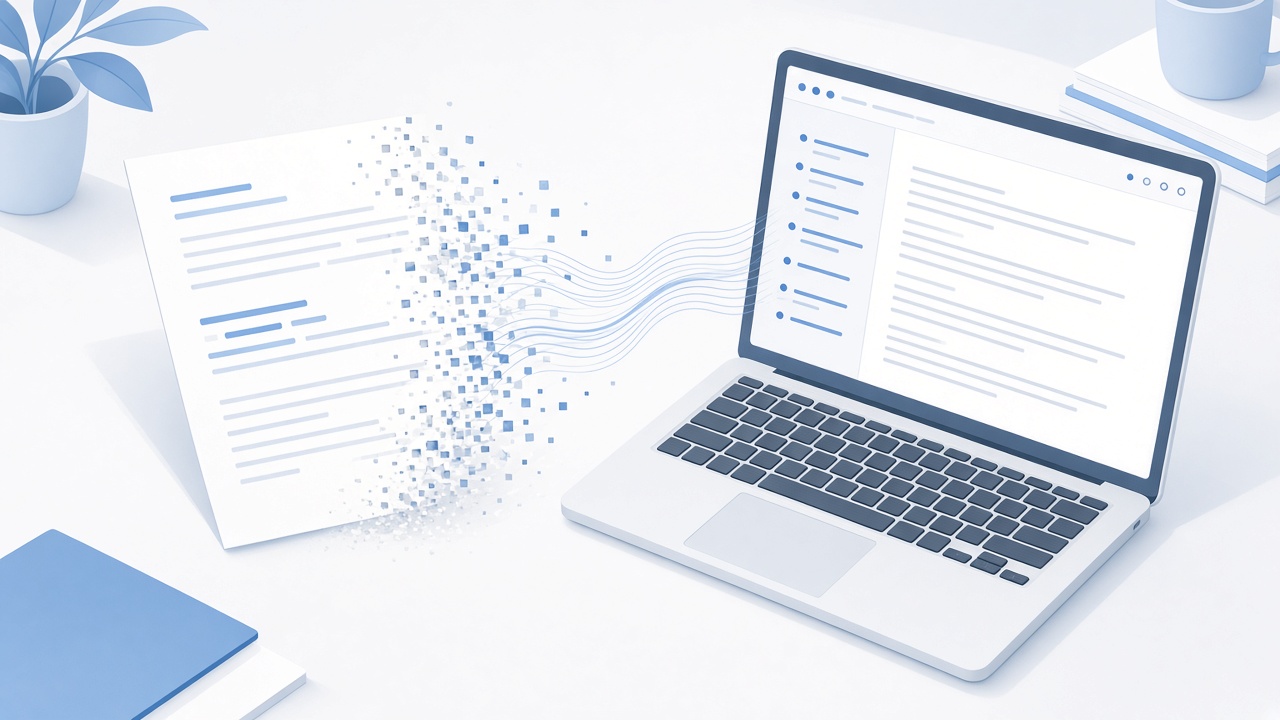
Человек приносит фото договора или скан конспекта и хочет получить текст, который можно править. Для этого у DeepSeek есть отдельная открытая линейка OCR. Её легко спутать с чатом, куда тоже можно приложить картинку, но задачи у них разные.
Две модели, две даты
В списке выпусков репозитория DeepSeek-OCR первая модель отмечена 20 октября 2025 года, а 27 января 2026 года там же появился DeepSeek-OCR 2. У второй версии в шапке репозитория указана лицензия Apache 2.0, у первой — MIT. Перед тем как встраивать модель в продукт, лицензию стоит перечитать в самом репозитории.
Имена весов в примерах авторов: deepseek-ai/DeepSeek-OCR и deepseek-ai/DeepSeek-OCR-2. На нашем сайте файлов модели нет: веса скачивают из карточки модели, если компьютер потянет запуск.
Что сказать модели
В описании OCR 2 есть два коротких приглашения. Одно — с пометкой grounding и просьбой перевести документ в markdown, то есть сохранить структуру страницы. Второе — Free OCR, простое распознавание текста без разметки. Команды и размеры изображения берите из README той версии, которую скачали: примеры первой и второй модели не взаимозаменяемы.
Пример OCR 2 авторы собирали в среде с CUDA 11.8 и torch 2.6.0. Это их стенд, а не единственная рабочая связка.
Чем OCR не является
В документации API DeepSeek на 24 октября 2026 года основная модель называется deepseek-flash, её обслуживает DeepSeek-V4.1-Flash-1017. В чат можно приложить фото и попросить пересказ, список полей или комментарий к таблице. Но это ответ языковой модели, а не прогон открытых весов OCR.
Если задача — «посмотри, что на снимке, и объясни», хватает чата. Если нужно пакетно забирать текст со сканов, передавать его в свою программу и не платить за каждую страницу, смотрят в сторону открытых весов OCR. Что умеет сама модель чата, разобрано в обзоре DeepSeek V4.1-Flash, а программный доступ — в материале про ключ DeepSeek API.
Как не испортить результат
Печать поверх цифр, бледная копия и рукописный текст дают пропуски. В счетах, договорах и анализах сверяйте числа с бумагой, а не только с распознанным текстом.
OCR 2 не создаёт новые страницы и не переводит. Сначала получают текст на языке документа, а перевод, если он нужен, делают отдельным запросом — как его поставить, описано в материале про перевод в DeepSeek.
Код запуска в репозитории обновляется. Перед установкой откройте README нужной версии и не смешивайте команды первой и второй модели в одном окружении.